

Gemini teď umí složit hudbu
Google přidal do aplikace Gemini generování hudby přes model Lyria 3. Je to zatím beta verze dostupná přes webové rozhraní. Do mobilu to má dorazit v následujících dnech.
Pokud ještě nevyužíváš některý z AI modelů pro generování hudby (Suno, Udio, Eleven Music…), tak by se ti mohlo hodit vědět, proč bys měl(a). Při tvorbě obsahu hudbu potřebuješ a hledisko rychlosti, dostupnosti hudby a práv k použití je dost zásadní. Díky AI si najednou bez knihovny zvuků uděláš vlastní podkres k prezentaci, internímu videu, reelsu, pozvánce na event nebo klidně jen k “status update” videu pro tým.
Lyria 3 (a platí to i pro ostatní AI generátory hudby) ti do ruky dávají nástroj, ve kterém si určíš styl, tempo, typ vokálů a Gemini to poskládá tak, aby to znělo muzikálně.
Lyria 3 zatím umí jen 30 sekundové tracky, které ale zní velmi slušně.
Chceš ukázky? Ale beze všeho:
Nebo něco, co by po ustřihnutí druhé poloviny šlo použít třeba jako jingle pro podcast/video.
Google Little Language Lessons - konkurence Duolinga?
Little Language Lessons je sada krátkých jazykových experimentů od Google Labs postavených na modelech Gemini. Nejde o klasický kurz, spíš o chytré mikronástroje do konkrétní chvíle:
Tiny Lesson ti vygeneruje slovíčka, fráze a pár poznámek ke gramatice pro situaci, kterou mu popíšeš
Slang Hang vytvoří přirozený dialog a vysvětlí idiomy a slang
Word Cam použije kameru jako rychlou slovní zásobu na věci kolem tebe.
Google to rámuje jako doplněk k běžnému studiu, který má pomoci propašovat jazyk do každodennosti.
Takže, rodí se nová konkurence pro známé Duolingo? Asi zatím ne. Duolingo je totiž plnohodnotná aplikace s dlouhodobou strukturou jazykového kurzu, postupem v lekcích a hodně silnou motivací přes gamifikaci, body, úrovně a hlavně návyk ve stylu každý den aspoň chvilku.
AI se dnes objevuje u obou aplikací, ale u každé z nich jinak. Little Language Lessons stojí celé na generování na míru, tedy situace, slang, popis věcí okolo tebe. Duolingo přidává AI funkce jako vysvětlení chyb, které firma postupně otevírá širšímu publiku, plus další konverzační a tréninkové prvky, ale pořád v rámci kurzu a jeho pravidel.
Little Language Lessons je zdarma, na druhou stranu nepokrývá tak širokou škálu jazyků jako Duolingo. Ale pokud jsi fanda do učení se jazykům, tak za “víkendové pohrání si” stojí.
Tavus Phoenix 4: video agent, který konečně umí i poslouchat
Tavus vydal Phoenix 4, nový real time model pro renderování lidské tváře a chování v konverzaci.
Novinka cílí na to, co nám u avatarů nejvíc vadí: když mluví, ale působí, že v hlavě mají prázdno. Že tam prostě nejsou vidět emoce tak, jako u reálných protějšků.
Phoenix 4 má být první systém, který v jednom modelu kombinuje plynulé mimické chování, aktivní naslouchání a řízení emocí v reálném čase, včetně mikro výrazů a pohybů hlavy, pohledu a mrkání.
Skoro až děsivé, co? Protože, tahle novinka bude mít vliv hlavně na rovinu důvěry v online rozhovoru.
Tavus přímo zmiňuje oblasti prodeje a zákaznické podpory, kde lidské signály jako přikyvování, pauzy nebo výraz porozumění ovlivňují, jestli druhá strana zůstane, nebo odejde. A stejný efekt čekej u onboardingu a školení: když AI průvodce působí, že tě vnímá, snáz udrží pozornost a konverzace se méně rozpadá na “otázka, odpověď, další“.
Technicky je zajímavé hlavně to, že Tavus míří “full duplex” chování, tedy že model zároveň poslouchá i reaguje, místo aby přepínal mezi režimy a pouštěl smyčky. Phoenix 4 má mít explicitní kontrolu nad více než deseti emočními stavy a umí plynule přecházet mezi nimi. Tavus to staví na behaviorálním modelu trénovaném na tisících hodin konverzačních dat a v kombinaci s jejich percepčním modelem Raven 1 má být schopný číst kontext a reagovat přiměřeně. Pokud si to chceš osahat, Tavus má veřejné demo.
A teď ta méně pohodlná část: čím víc výstupy z AI působí opravdově a reálně, tím víc je potřeba být fér. Pokud Phoenix 4 nasadíš do podpory nebo sales, transparentní označení, že jde o AI, je základ. Nejen kvůli etice, ale i kvůli riziku reputačního průšvihu, protože realistické video s emocemi se velmi snadno splete s člověkem a tím pádem se snadno zneužije. Nebo bys tohle viděl(a) jinak? Klidně to napiš do komentářů.
Claude Sonnet 4.6
Anthropic tento týden posunul Claude Sonnet na verzi 4.6 a udělal z ní výchozí model pro Free i Pro na claude.ai a v Claude Cowork. Co je super, že cena zůstává stejná jako u 4.5, ale schopnosti v kódování, práci s počítačem, dlouhém uvažování i plánování agentních úloh se zase o něco vylepšily. Což znamená, že řada věcí, kde ses dřív “pro jistotu“ přepínal(a) na dražší model, teď často projde i se Sonnetem.
Největší lákadlo verze 4.6 je 1M token kontext v betě. To je velikost, do které už reálně nacpeš celý větší repozitář, delší smlouvy, nebo balík interních podkladů a necháš model hledat souvislosti napříč vším najednou. Pokud děláš analýzu, vyplatí se změnit návyk: místo “tady máš výtah a zbytek dopovím“ dej modelu rovnou primární zdroje a chtěj konkrétní výstupy, třeba seznam rizikových bodů ve smlouvě, návrh refaktoringu, nebo kontrolu finančního modelu i s odůvodněním. Sonnet 4.6 je podle Anthropic silnější i v tom, že umí přes velký kontext lépe plánovat delší postup.
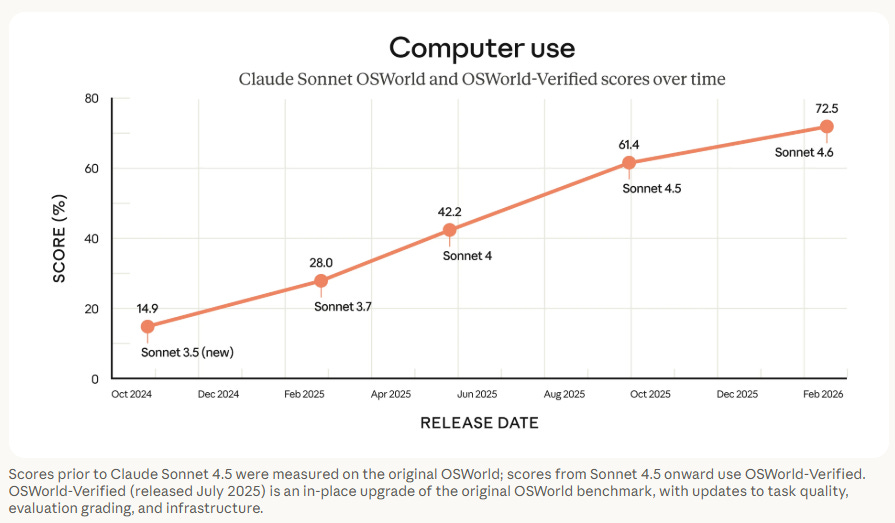
Druhá praktická věc je “computer use“, tedy schopnost ovládat aplikace podobně jako člověk. Anthropic ukazuje posun na benchmarku OSWorld a zmiňuje, že uživatelé vidí výkon blížící se člověku třeba u složitějších tabulek nebo vícekrokových webových formulářů napříč kartami v prohlížeči. To je ten typ práce, kde AI dává smysl, když jí dáš jasný cíl, omezíš prostor pro škody a necháš ji průběžně hlásit, co dělá. A protože web umí být zákeřný, Anthropic zároveň řeší odolnost proti prompt injection a tvrdí, že 4.6 je v tom znatelně lepší než 4.5.
Pokud používáš API nebo Claude Developer Platform, stojí za pozornost i novinky týkající se přemýšlení a práce s kontextem. Sonnet 4.6 podporuje adaptive thinking i extended thinking a v betě také context compaction, která průběžně shrnuje starší část konverzace, aby se efektivně vešlo víc. A u nástrojů typu web search a fetch Anthropic popisuje, že systém umí automaticky psát a spouštět kód pro filtrování výsledků, takže do kontextu nacpe jen to podstatné.
Gemini 3.1 Pro: chytřejší odpovědi a rychlejší cesta do firemních nástrojů
Začínal jsem dnešní vydání u Google a budu ho u něj i končit. Tento týden Google ukázal model Gemini 3.1 Pro, který má být lepší v úkolech, kde nestačí “něco vygooglit“, ale je potřeba domyslet souvislosti a dotáhnout řešení.
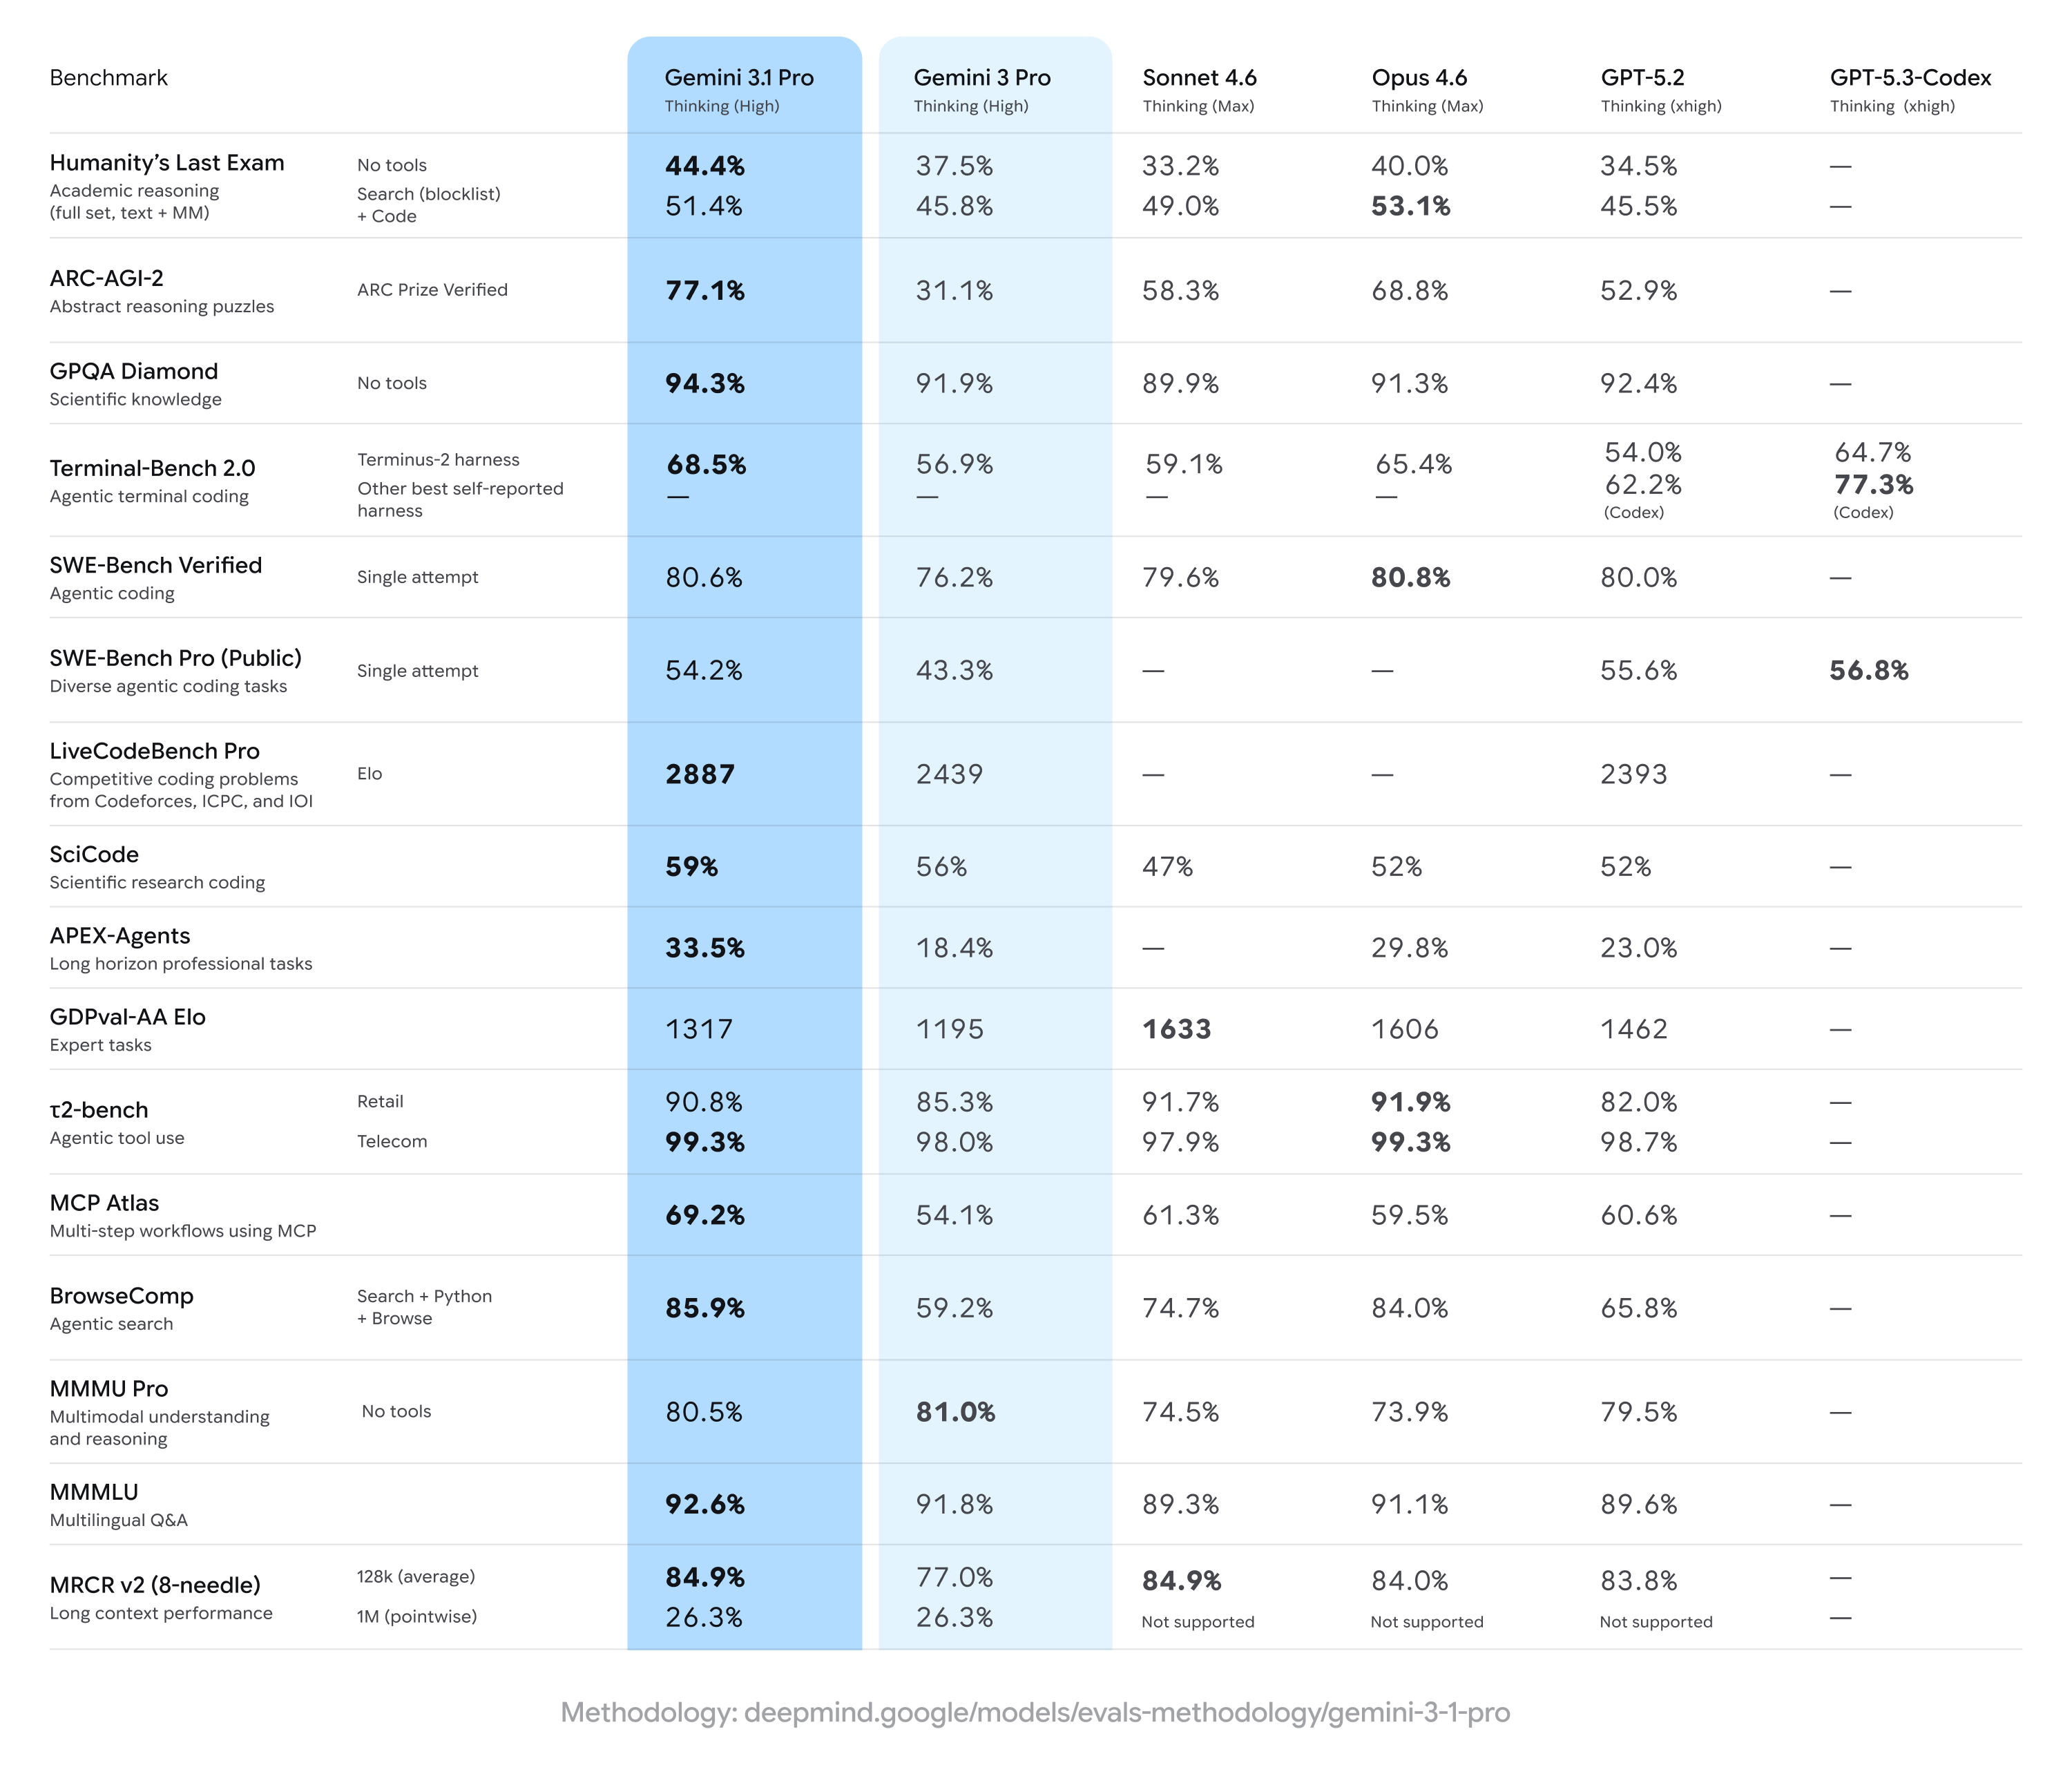
Google to opírá o měření ARC AGI 2 (zjednodušeně je to benchmark na abstraktní uvažování), kde má Gemini 3.1 Pro dosahovat 77,1 % a oproti předchozí verzi (Gemini 3 Pro) je to velký skok o více než 45 %! Pro nás smrtelníky to znamená hlavně menší šanci, že ti AI dá hezkou odpověď, která ale ve skutečnosti nic neřeší. Nebo je špatně.
V praxi to Google ukazuje na věcech, které si umíš představit i bez diplomu z informatiky: třeba vytvoření animovaného SVG obrázku (který rovnou můžeš použít na web) nebo poskládání jednoduchého živého přehledu dat, co se sám aktualizuje. Jinými slovy: méně “povídání o tom, jak by to šlo“, víc “tady to máš a můžeš s tím rovnou něco dělat“.
Pro vývojáře je dostupný přes Gemini API a v nástrojích jako Google AI Studio nebo Gemini CLI. Pro firmy pak přes Vertex AI a Gemini Enterprise.
Jasně, zatím je to preview a Google říká, že to chce ještě ověřit v praxi, hlavně u agentních workflow (AI, která udělá víc kroků za tebe). Ale i tak: Gemini 3.1 Pro míří na úkoly, které mají reálný dopad na práci, a Google ho bude chtít rovnou tlačit do ekosystému nástrojů.
A nakonec jedno “reklamní” AI video, které jsem spíchl za cca 20 minut komplet (vč. hudby i voiceoveru) a udělalo mi radost tím, jak pěkně vypadá.
Děkuji ti za přečtení dalšího vydání 5 tipů od Petra!
Pokud se ti líbilo, prosím, doporuč ho svým kamarádům přes toto tlačítko: